Empfohlen
BI & BerichterstattungBerichtsänderungen: Versionierung und Übergang
Warum alte Zahlen nicht mehr stimmen, wenn sich eine Berichtsdefinition ändert. Versionen, Änderungsnotizen und Übergangszeit; Stand bei Floemdata.
Verständliche Erklärungen zu den Systemen und Begriffen hinter dem Produkt.
Warum alte Zahlen nicht mehr stimmen, wenn sich eine Berichtsdefinition ändert. Versionen, Änderungsnotizen und Übergangszeit; Stand bei Floemdata.
Ein langsamer Bericht summiert oft bei jedem Öffnen alle Rohzeilen neu. Wie vorab aggregierte Tabellen helfen, was Aktualität kostet und was Floemdata hat.
Eine richtige Zahl genügt nicht: Das Team muss den Bericht richtig lesen. Fünf kurze Gewohnheiten zu Periode, Definition und Vergleich; Stand bei Floemdata.
Woher kommen die Labels für überwachtes Lernen? Inkonsistente Labels, kleine Datenmengen und ein Labeling-Prozess im KMU-Maßstab; Stand bei Floemdata.
Ein Eins-zu-viele-Join dupliziert Zeilen und bläht Summen auf. So erkennen und vermeiden Sie das, mit Rechnungs-Zahlungs-Beispiel; Stand bei Floemdata.
Ein Sprachmodell Berichte zusammenfassen zu lassen spart Zeit, birgt aber erfundene Deutungen und falsche Zahlen. So begrenzen Sie das Risiko; Floemdata-Prinzip.
Wechselt die Region eines Kunden, dürfen alte Berichte nicht kippen. Typ 1 gegen Typ 2 bei langsam ändernden Dimensionen, Auswahl und Stand bei Floemdata.
NULL ist nicht null. Leere Werte verschieben Durchschnitte, Zählungen und Joins unbemerkt. So erkennen und behandeln Sie sie; Stand bei Floemdata.
Daten aus einem laufenden ERP auslesen, ohne es zu bremsen: Erstladung außerhalb der Geschäftszeit, Batches, Pausen, Timeout, Lesezugriff. Regeln bei Floemdata.
Wie die Centdifferenz zwischen Zeilen- und Belegrundung in der Summe sichtbar wird und wie Sie sie nachverfolgen. Beispiel und Rundungsdifferenz bei Floemdata.
Die Differenz zwischen Budget und Ist sagt allein wenig. Vorzeichenregel, Prozentfalle, Preis-Mengen-Zerlegung und der heutige Stand von Floemdata beim Thema Budget.
Wie lange sollten Daten bleiben? So klären Sie Aufbewahrung, Archivierung und Löschung; gesetzliche Fristen erfragen Sie beim Rechtsberater. Stand bei Floemdata.
Welche Warnungen braucht man wirklich? Minimalset für Datenaktualität, Mengenabweichung und Laufzeitfehler und der heutige Stand bei Floemdata.
Was zeigt die Aufteilung offener Forderungen in Fälligkeitsstufen, was verbirgt sie? Lesehilfe, häufige Fehler und die Forderungsalterung bei Floemdata.
Inkrementelles Laden ist schnell, übersieht aber gelöschte und rückdatierte Sätze. Wie Watermark, Überlappung und Vollabzug helfen und was Floemdata heute kann.
Was sollten Sie messen, damit die KI-Rechnung keine Überraschung wird? Token, Caching, Wiederholungen, Kosten je Ergebnis: ein Messplan ohne erfundene Preise.
Zeigen zwei Berichte verschiedenen Umsatz, liegt es an der Definition. KPI-Glossar: eine Definition, ein Verantwortlicher; Floemdatas Kennzahlenkatalog.
Lagerumschlag und Bestandsalterung stellen dieselbe Frage auf zwei Wegen. Berechnungsvarianten, Fallen bei Durchschnittsbestand und Liegezeit, Floemdata-Stand.
Vom Brutto- zum Nettoumsatz: Wie Retouren und stornierte Belege die Zahl verfälschen, Kontrollen gegen Doppelzählung und der Stand bei Floemdata.
RAG lässt eine KI aus Firmendokumenten antworten und die Quelle nennen, das Data Warehouse berechnet die Zahlen. Der Unterschied und die richtige Aufgabenverteilung.
Firmenspezifische U_-Felder in SAP B1 enthalten wertvolle, aber fragile Berichtsdaten. Wie man sie findet, Werte bereinigt und sauber ins Data Warehouse überführt.
Eine Euro-Rechnung wird in Lira bezahlt, und die Berichte zeigen zwei Beträge. Was bei Belegkurs, Fremdwährungsbetrag und Kursdifferenz in SAP B1 zu beachten ist.
Im Quellsystem wird eine Spalte ergänzt, gelöscht oder umbenannt. Was soll die Pipeline an diesem Tag tun? Datenvertrag, drei Reaktionen und der Stand bei Floemdata.
Steht ein Kunde unter zwei Nummern im ERP, stimmen Rankings nicht. Drei Schritte zum Finden von Dubletten, eine Zuordnungstabelle und der echte Stand bei Floemdata.
Ändert sich eine Kundennummer, was wird aus alten Berichten? Surrogat- gegen fachlichen Schlüssel, Auswahlkriterien und was Floemdata heute nutzt.
Synthetische Daten prüfen Logik und Konsistenz, beweisen aber nicht, wie Schema und Schmutz eines echten Systems aussehen. Grenzen, Beispiel, richtige Reihenfolge.
Ein Backup beweist erst etwas, wenn es zurückgespielt wurde. Sicherung, Restore-Test, RPO und RTO für ein KMU-Warehouse und der Stand bei Floemdata.
Ein neu gestarteter Ladevorgang darf Zeilen nicht verdoppeln. Eindeutige Schlüssel, Upsert, Versionen und was wir bei Floemdata fanden und nicht fanden.
Soll ein Bericht jeden Morgen kommen oder nur bei Bedarf? Empfänger, Zeitpunkt, Format und Datenaktualität beim geplanten Versand, plus der Stand bei Floemdata.
Ein Verkauf kurz vor Mitternacht landet am falschen Tag. UTC und Ortszeit, Sommerzeit, Datumsfelder ohne Uhrzeit: Fallen in Tageszahlen.
Ein Audit-Trail zeigt später, wie eine Zahl entstanden ist. Wir erklären, welche Protokolle sinnvoll sind und was für die Compliance zu beachten ist.
Eine Live-Abfrage ist genau, aber langsam, ein Cache schnell, aber womöglich veraltet. Wir zeigen die Balance und wann Caching unbedenklich ist.
Wie richtet man die Synchronisation ein, wenn Daten lokal und in der Cloud liegen? Richtung, Latenz, Konflikte und Sicherheit in hybriden Umgebungen.
Data Lineage zeigt, welche Schritte eine Zahl von der Quelle bis zum Bericht durchläuft. Wir erklären, warum es wichtig ist und wie man beginnt.
Modell verbessern oder Daten? Wir erklären, wie die Datenqualität die Modellleistung beeinflusst und wann sich welche Investition zuerst lohnt.
Excel ist flexibel, ein Systembericht konsistent; was passt wann? Wir vergleichen Versionschaos, Formelfehler und eine einzige Wahrheitsquelle.
End-to-End-Automatisierung verkettet die Schritte vom Datenabruf bis zum Bericht ohne Handarbeit. Wir erklären, wo Freigaben nötig sind und wo man anhält.
Warum ein KI-Modell im Betrieb versionieren und zurückrollen können? Wir zeigen, wie Modell-, Daten- und Codestände zusammen verwaltet werden.
Lakehouse oder klassisches Data Warehouse? Wir erklären den Unterschied beider Architekturen und warum ein kleines Unternehmen einfach beginnen sollte.
Soll die Zeitdimension eines Berichts Tag, Stunde oder Minute sein? Wir erklären, wie Detailgrad, Zeitzonen und Kalenderunterschiede eine Zahl verändern.
Zu viele Berichte ermüden: Niemand weiß, welchen er ansehen soll. Wir zeigen Berichtsinventar, gemeinsame Definitionen und alarmorientierte Dashboards.
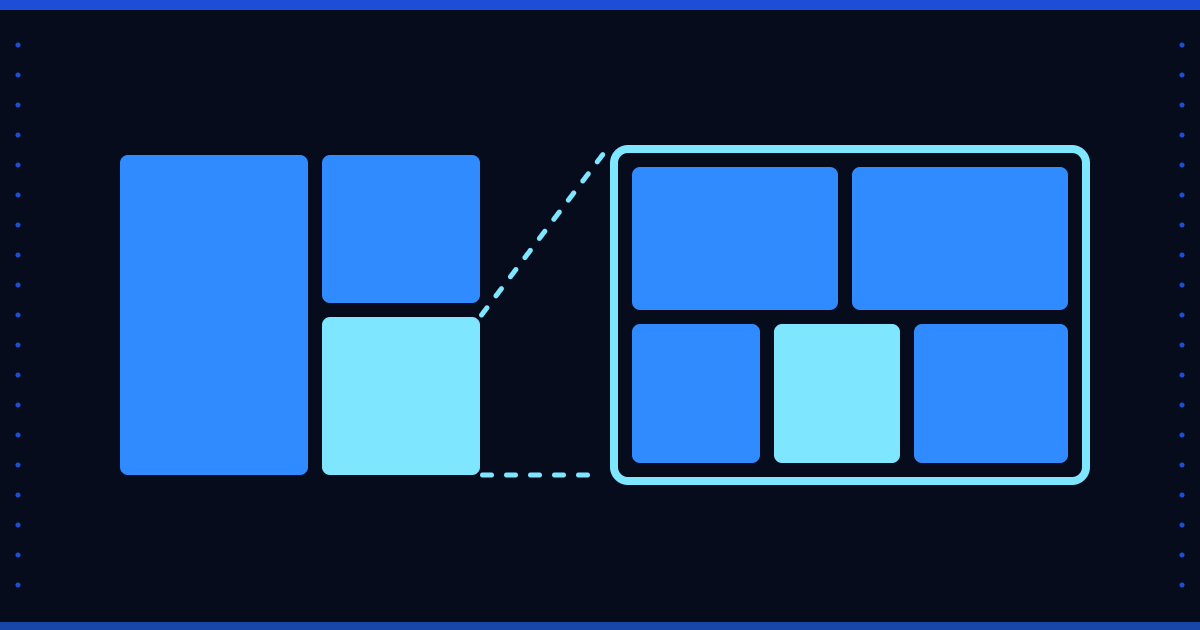
Der Wechsel von der Übersicht ins Detail beschleunigt ein BI-Dashboard. Wir erklären Gestaltungsprinzipien und die Reihenfolge der Dimensionen.
Ein Datenkatalog hält fest, wo Daten liegen und was sie bedeuten. Wir erklären das Metamodell dahinter und wie ein kleines Team beginnen kann.
Wie stark müssen Finanzdaten geschützt werden? Ein risikobasierter Blick auf Signatur und Verschlüsselung, Verbindungssicherheit und Zugriffsregeln.
Echtzeit-Strom oder stündlicher Batch-Abruf? Wir erklären, wie man die passende Aktualisierungsfrequenz für SAP-B1-Daten aus Latenz, Last und Bedarf wählt.
Fehler beim Datenabruf und bei der Umwandlung sind unvermeidlich; entscheidend ist der Weg zurück. Bestätigter Fortschritt, Monatsabschluss.
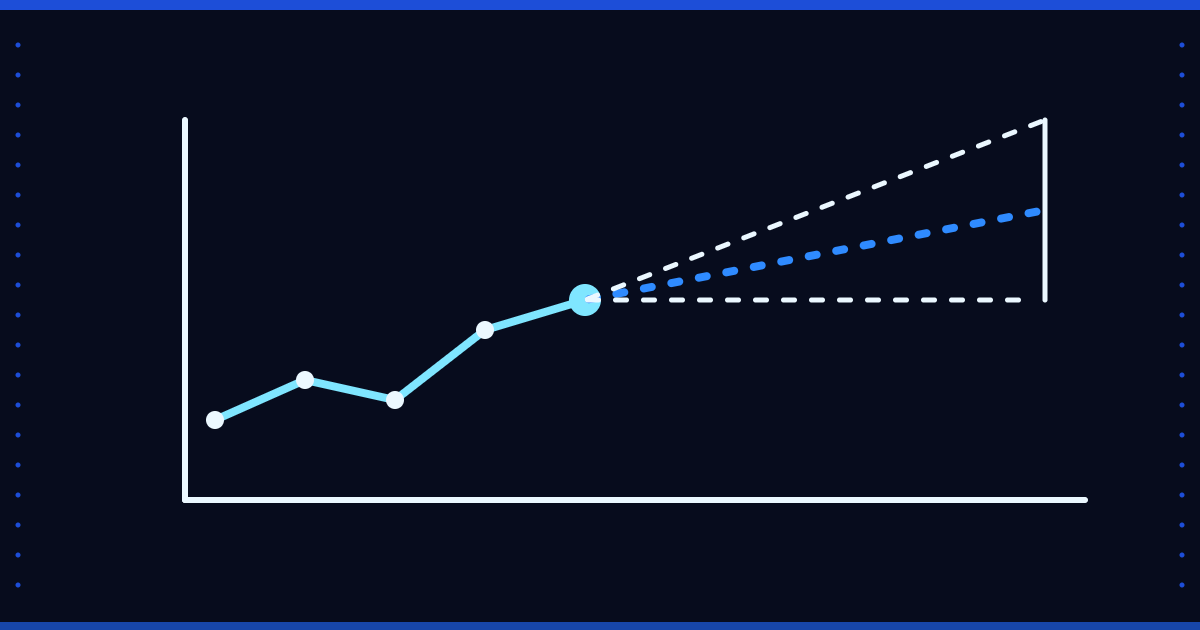
Warum Saisonalität und Zahlungsverhalten bei der Cashflow-Prognose zählen. Wir zeigen den einfachen Einstieg, die Kontrolle gegen Istwerte und die Grenzen.
Was prüfen, bevor man KI-Ausgaben im Betrieb vertraut? Eine praktische Checkliste zu Validierung, Erklärbarkeit und menschlicher Aufsicht, mit NIST-Bezug.
Ist maschinelles Lernen mit wenig Daten möglich? Erst eine einfache Basislinie, dann sorgfältige Validierung: wann man startet und wann man wartet.
Berichte können trotz richtiger Zahlen täuschen: Simpson-Paradoxon, gekappte Achsen, gemittelte Verhältnisse. Häufige Fallen mit fiktiven Beispielen.
Stimmt der Bericht mit dem Quellsystem überein? Wir beschreiben eine zweischichtige Abstimmung und warum Differenzen gezeigt statt verborgen werden sollten.
Personenbezogene Daten in BI-Berichten unter dem türkischen KVKK: Pflicht zur Datensicherheit und Zugriffsregeln. Keine Rechtsberatung.
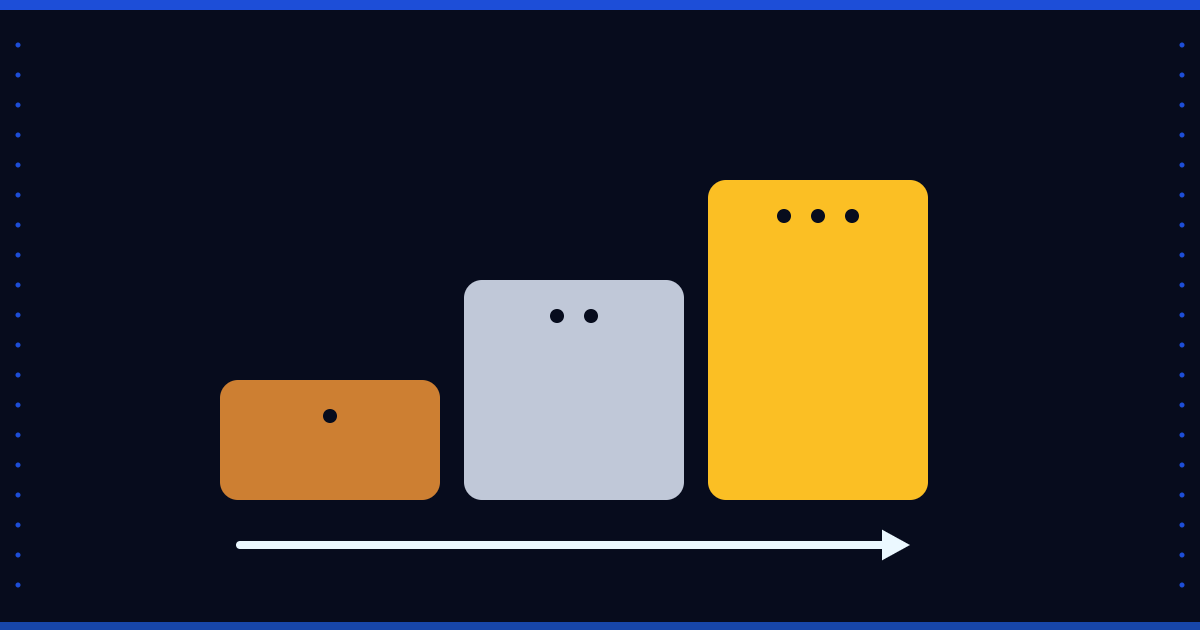
Die Schichten Bronze, Silver und Gold ordnen Daten vom Rohzustand bis zum Bericht. Wir erklären ihre Aufgaben und das Gegenstück in Floemdata Analytics.
Eine Checkliste zur Datenqualität: Vollständigkeit, Eindeutigkeit, Gültigkeit, Konsistenz. Was automatisch läuft und was ein Mensch prüft.
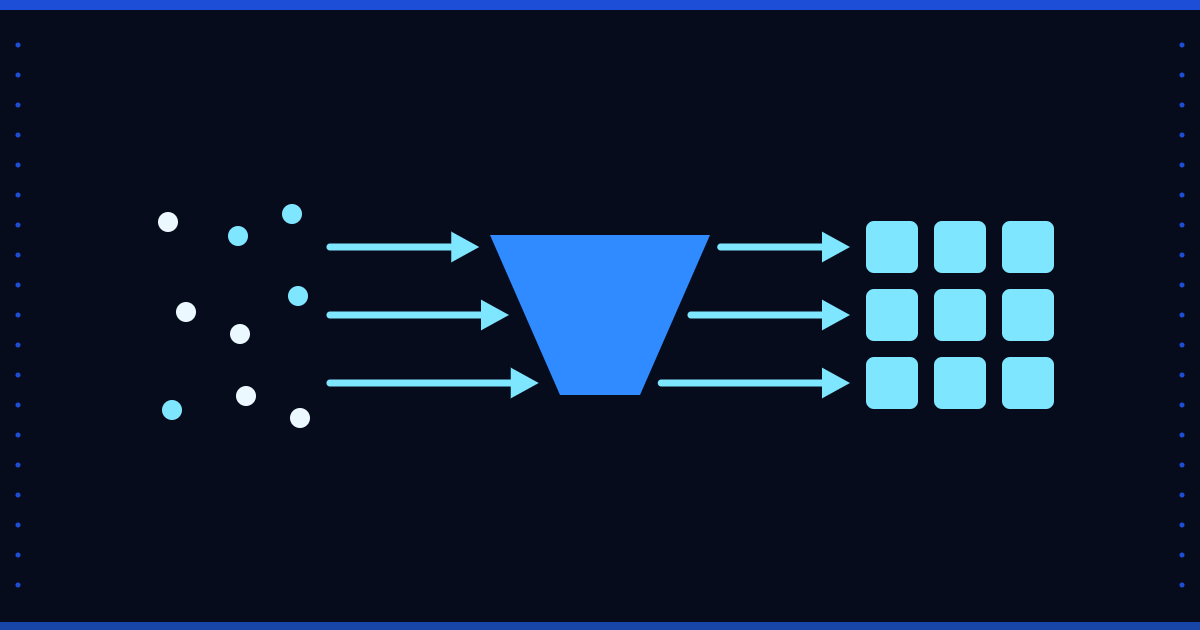
ETL überführt Daten aus mehreren Quellen ins Warehouse und wandelt sie um. Wir erklären, wann es nötig ist, wann es Aufwand ist und den Unterschied zu ELT.
Fünf häufige Fehler beim betrieblichen Einsatz von KI-Werkzeugen, jeweils mit Gegenmittel: vertrauliche Daten, ungeprüfte Ausgaben, Rechnen durch das Modell.
Eine BI-Kennzahl gehört einmal und an einer Stelle definiert: Summen, Verhältnisse, Zeitdimension. Wir erklären den Katalogansatz und Fallstricke wie Arbeitstage.
KI kann im Data Warehouse Prognosen, Anomalieerkennung und Automatisierung unterstützen. Wir erklären, was zuerst stehen muss und wo die Grenzen liegen.
Fragen in natürlicher Sprache machen BI einfacher, aber ein Modell kann Zahlen erfinden. Wir erklären, warum eine geprüfte Berichtsdefinition sicherer ist.
Llama hat eine Milliarde Downloads erreicht; Metas 2026 vorgestelltes Muse Spark ist laut CNBC geschlossen. Wir vergleichen beide Ansätze.
SAP-B1- und Marktplatzdaten in einem Warehouse zu vereinen ist schwieriger als gedacht: verschiedene Schlüssel, Retouren, Stornos, Neuladungen und Abstimmung.
Agentische KI geht über den Chat hinaus und erledigt Aufgaben. Wir erklären Multi-Agent-Systeme und mögliche Einsatzfelder im Unternehmen.
Anthropic hat im Mai 2026 eine Series-H-Runde über 65 Milliarden Dollar verkündet; Andrej Karpathy wechselte zum Unternehmen. Fakten mit Quellen.
So wählen Sie zwischen Claude und ChatGPT: Aufgabenart, Datenbedingungen, Kosten und ein Test mit Ihren eigenen Aufgaben.
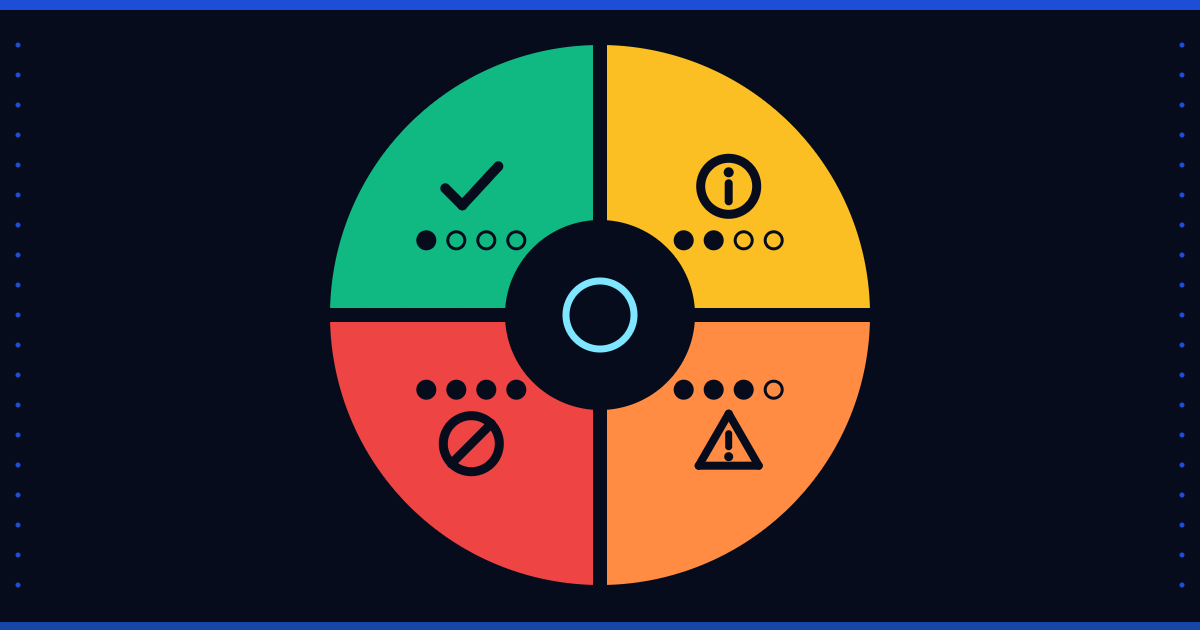
Die Pflichten für Hochrisiko-KI in der EU-KI-Verordnung wurden verschoben. Wir erklären die vier Risikostufen und was 2026 gilt.